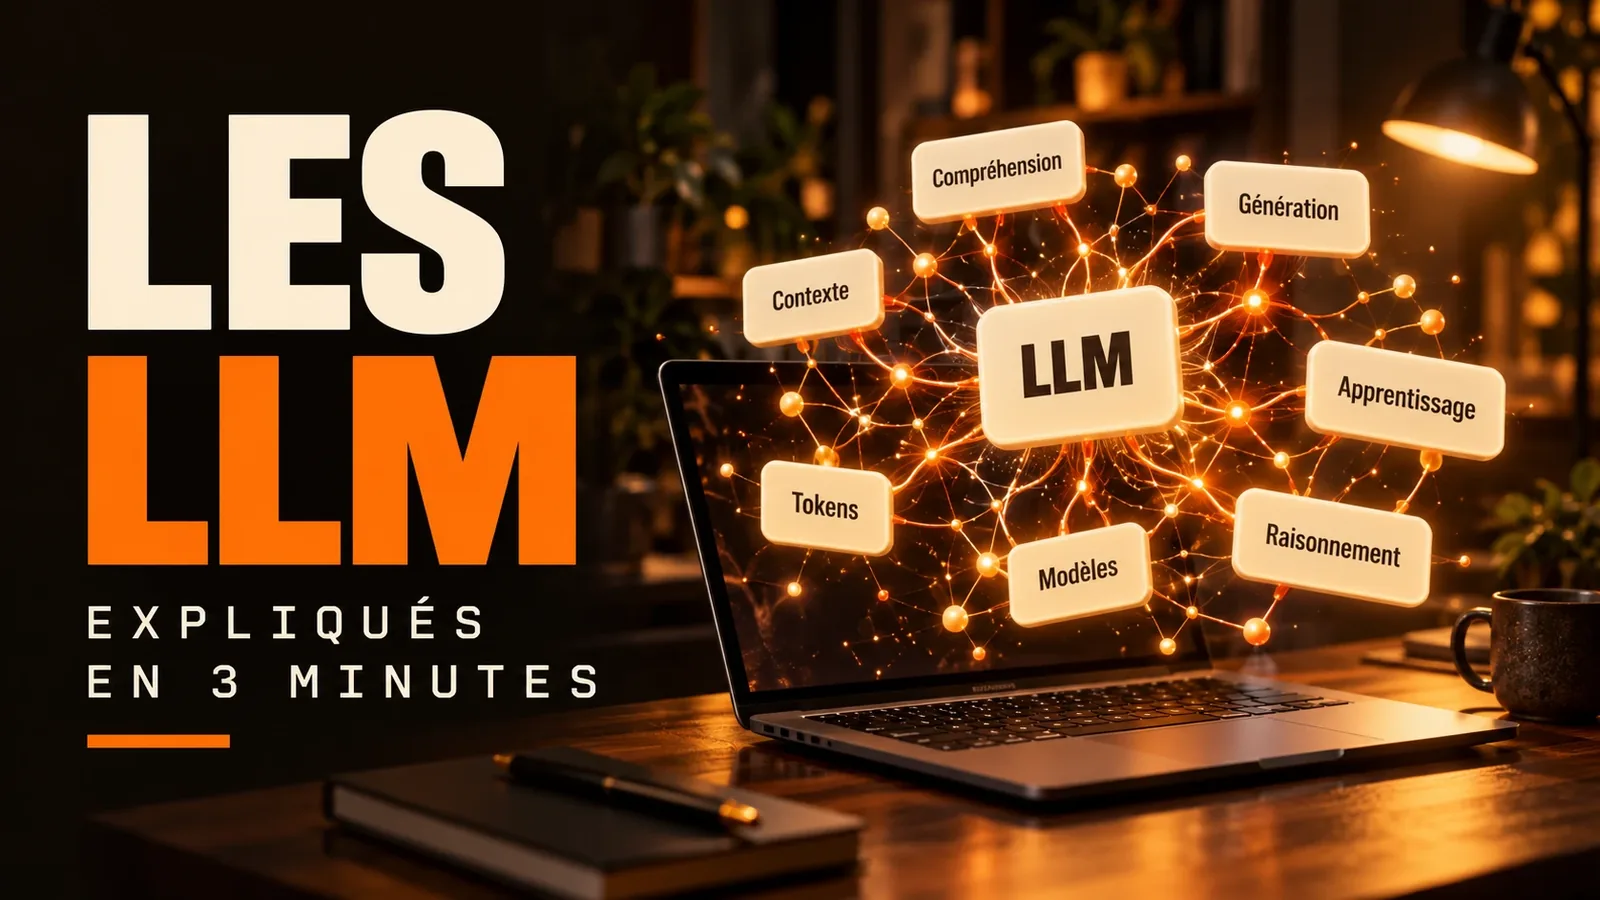


Tout le monde parle des LLM. Mais c’est quoi exactement ?
Pas de jargon compliqué ici : je t’explique tout, vite fait bien fait, pour que tu comprennes comment ça marche et ce que ça vaut vraiment. Accroche-toi, c’est parti.
LLM : ça veut dire quoi ?
LLM, c’est l’acronyme de Large Language Model, ou en français grand modèle de langage. On va rester sur « LLM », c’est plus simple.
Concrètement, un LLM, c’est une intelligence artificielle qui a « mangé » des tonnes de textes. Le but ? Apprendre à manipuler le langage humain, et surtout à générer du texte tout seul. Un peu comme un perroquet : il recombine ce qu’il a vu, sans forcément le comprendre.
C’est ce qui fait tourner ChatGPT, Claude, Gemini ou Mistral.
Comment fonctionne un LLM ?
Quand tu poses une question à ChatGPT, il ne réfléchit pas comme un humain. Il prédit le morceau de texte le plus probable après ce que tu viens de taper, en se basant sur des milliards d’exemples. C’est tout. Pas d’émotions, pas d’intention : de la prédiction.
Pour bien comprendre, voici les 3 grandes étapes.
1. L’apprentissage
Le LLM est entraîné sur d’immenses bases de données textuelles : encyclopédies, livres, forums, code, articles scientifiques. Il ne lit pas au sens humain du terme, mais il absorbe des milliards de phrases pour repérer comment on parle et comment on écrit.
Tout ça grâce à une architecture appelée transformer, présentée par des chercheurs de Google en 2017 dans le papier Attention is all you need. Neuf ans plus tard, tous les modèles dont on parle en descendent encore. Plus il y a de couches et de paramètres, plus le modèle est capable, mais plus il coûte cher à entraîner et à faire tourner.
2. L’identification des schémas
Contrairement à un moteur de recherche qui te ressort un texte existant, un LLM analyse les relations entre les mots. Si tu demandes « quelle est la capitale de la France ? », il répond Paris parce que dans énormément de textes, « capitale » + « France » mène à « Paris ».
Ce tour de magie repose sur deux éléments clés :
- Le self-attention : le modèle sait sur quels mots se concentrer dans ta phrase. Il ne lit pas tout au même niveau, il pondère ce qui compte.
- Le positional encoding : comme les mots sont traités en parallèle et pas dans l’ordre, cette technique permet de garder la notion de séquence.
C’est ce combo qui permet de traiter des phrases complexes, même quand les mots liés sont très éloignés les uns des autres.
3. La prédiction
Le LLM devine ce qui vient ensuite, en choisissant parmi les suites les plus probables selon le contexte. Un perroquet sous stéroïdes, qui a lu une bibliothèque entière.
Petite précision de vocabulaire : le modèle ne manipule pas des mots mais des tokens, des fragments de mots. C’est aussi l’unité qui sert à facturer les API. Les autres termes du domaine sont dans notre lexique de l’IA.
Pourquoi il écrit mot après mot (et ce que ça change pour toi)
Le texte qui s’affiche petit à petit dans ChatGPT n’est pas un effet visuel. C’est vraiment comme ça qu’il travaille : il produit un token, puis le suivant, puis le suivant, et chaque nouveau token est calculé en tenant compte de tout ce qui a déjà été écrit. On appelle ça la génération autorégressive.
Conséquence directe : il ne revient jamais en arrière. Toi, tu fais un plan, tu écris, tu ratures. Un LLM s’engage sur chaque mot dès qu’il l’a posé. S’il part sur une mauvaise piste dès la première phrase, il a plus de chances de la défendre jusqu’au bout que de se corriger.
C’est aussi pour ça qu’il bute sur les problèmes où tout se tient en même temps, comme une grille de Sudoku difficile. Il doit remplir une case avant de connaître les contraintes de toutes les autres.
Les modèles dits « de raisonnement », lancés par OpenAI avec o1 en septembre 2024, contournent le problème sans changer la mécanique : ils écrivent d’abord un brouillon de réflexion, puis la réponse. Et tu peux appliquer la même astuce avec n’importe quel modèle.
Astuce : demande le plan avant le texte. Tu forces le modèle à poser la structure d’abord, et tu corriges le tir avant qu’il ne s’engage sur 800 mots dans la mauvaise direction.
Prompt : le plan d’abord
Avant d’écrire quoi que ce soit, propose-moi un plan en 5 points pour [ton sujet]. Attends ma validation, puis rédige la version complète en suivant ce plan.
Pour être complet : écrire mot après mot n’est pas la seule façon de faire écrire une IA. Deux pistes de recherche s’en écartent.
- La diffusion : le modèle part d’un texte entièrement brouillé et le nettoie en plusieurs passes, tous les mots en parallèle, comme une image qui se précise. Google a présenté Gemini Diffusion en mai 2025 : très rapide, mais au niveau de ses petits modèles, pas des meilleurs.
- Du grossier au précis : en octobre 2026, des chercheurs de Stanford ont publié Next-Concept Modeling (NCM). Le modèle pose d’abord une version très compressée du sens de tout le texte, puis ajoute les détails couche par couche jusqu’au mot exact. Un peu comme toi quand tu pars d’une idée, puis d’un plan, puis des phrases. Les auteurs annoncent une génération 10 à 31 fois plus rapide que les meilleurs modèles de diffusion.
Garde la tête froide sur NCM : il a surtout été testé sur des modèles d’environ 100 millions de paramètres, quand un modèle ouvert comme Llama monte à 405 milliards. Rien ne prouve encore que l’idée tienne à cette échelle. Pour tes usages d’aujourd’hui, l’écriture mot après mot reste la norme. Ces pistes t’aident surtout à comprendre pourquoi ton assistant se trompe comme il se trompe.
D’où viennent les LLM ? Six jalons
Pour situer les choses sans y passer la journée :
- 2017 : Google publie Attention is all you need et invente le transformer.
- Juin 2020 : OpenAI sort GPT-3, 175 milliards de paramètres. Le moment où l’échelle change tout.
- 30 novembre 2022 : ChatGPT est lancé et fait passer les LLM du labo au grand public.
- Septembre 2024 : arrivée des modèles dits de raisonnement, qui produisent une chaîne de réflexion avant de répondre.
- Janvier 2025 : DeepSeek publie R1 sous licence MIT. Un modèle de raisonnement en poids ouverts, l’écart entre fermé et ouvert se resserre.
- 2026 : le multimodal natif et les architectures à experts deviennent la norme sur les modèles phares.
La chronologie détaillée des modèles OpenAI est dans notre article sur GPT-3. Pour les autres labos, on a écrit l’histoire d’Anthropic et celle de Mistral AI.
Tous les LLM ne se valent pas
Il existe deux grandes familles.
Les modèles propriétaires (fermés) : tu y accèdes via une interface ou une API, sans voir ce qu’il y a dedans. Chez OpenAI, la génération GPT-6 a démarré le 3 septembre 2026 avec GPT-6 Astra, même si la conversation de ChatGPT tourne surtout sur GPT-5.6, sorti le 9 juillet. Anthropic a sorti Claude Opus 5.5 le 22 septembre 2026. Google fait tourner la famille Gemini 3, dont les versions Flash pensées pour la vitesse.
Les modèles à poids ouverts : tu peux les télécharger, les modifier, les faire tourner sur ta machine. Meta (Llama), Alibaba (Qwen), DeepSeek et Mistral jouent dans cette cour. Mistral a publié sa gamme Mistral 3 sous licence Apache 2.0, y compris son plus gros modèle : usage commercial autorisé, sans redevance.
Attention au vocabulaire : « poids ouverts » ne veut pas dire « open source » au sens strict. Les paramètres sont téléchargeables, mais les données d’entraînement et la recette complète restent presque toujours privées.
Ce qui a changé depuis 2023
Si tu as lâché le sujet il y a deux ans, voilà les quatre évolutions à connaître.
- Le raisonnement : certains modèles produisent une chaîne de réflexion avant de répondre. Plus lent et plus cher, mais nettement meilleur en maths, en logique et en code.
- Le mixture of experts (MoE) : au lieu d’activer tout le modèle à chaque requête, seule une fraction des « experts » s’allume. D’où des modèles énormes sur le papier mais utilisables en pratique. Mistral Large 3 annonce par exemple 675 milliards de paramètres au total, dont 41 milliards actifs.
- Le multimodal natif : image, audio et texte passent par le même modèle, au lieu d’être bricolés par-dessus un modèle de texte.
- Le contexte long et les agents : les fenêtres de contexte se comptent en centaines de milliers de tokens, voire en millions, et les modèles enchaînent des actions (chercher, exécuter du code, appeler un outil) au lieu de juste répondre.
Pour brancher un LLM sur tes propres documents, la technique standard s’appelle le RAG. On lui consacre un article dédié.
À quoi ça sert concrètement ?
Les LLM savent lire, écrire, traduire, résumer, coder : générer des angles quand tu sèches, transformer une consigne en code exécutable, résumer un article scientifique ou une réunion, pré-rédiger des réponses au support client.
Ils sont polyvalents parce qu’entraînés sur des volumes gigantesques. On les appelle des foundation models : ils servent de base à plein d’usages différents. Certains résolvent un problème sans aucun exemple, c’est le zero-shot learning ; si tu donnes un ou deux exemples, on parle de few-shot. C’est l’une des techniques de base pour écrire un bon prompt.
Côté architecture, il existe trois formats : les encodeurs (ex : BERT) pour comprendre le langage, les décodeurs (ex : la famille GPT) pour générer du texte, et les modèles encodeur-décodeur (ex : T5) pour traduire ou convertir. La quasi-totalité des modèles grand public d’aujourd’hui sont des décodeurs.
Mais attention, tout n’est pas rose
Les hallucinations
Un LLM peut inventer des infos en toute confiance, simplement parce que ça « colle » statistiquement. Il te sortira une source, une date ou un nom qui n’existent pas, sans trembler. Les modèles de raisonnement réduisent le problème, ils ne le suppriment pas. Vérifie toujours ce qui compte.
Les biais et la censure
Si les données sont biaisées, le modèle répète les mêmes biais. Et quand il est contrôlé par une entreprise ou soumis à une réglementation nationale, il peut être filtré ou orienté. Pose une question politiquement sensible à des modèles de pays différents : les réponses ne se ressemblent pas.
La confidentialité
Ce que tu tapes dans un assistant grand public peut être conservé et, selon le type de compte, utilisé pour améliorer les modèles. Sur les offres pro, l’entraînement sur tes données est en général désactivé par défaut, mais ça se vérifie dans les conditions du service. Sujets sensibles (santé, finance, juridique) : regarde du côté d’un modèle ouvert hébergé chez toi.
Et pourquoi ce n’est pas encore partout ?
Parce que créer un LLM de premier plan reste très cher et très complexe : il faut des milliers de GPU haut de gamme (Mistral indique avoir entraîné Mistral Large 3 sur 3 000 GPU H200 de NVIDIA), des volumes de textes gigantesques souvent indisponibles dans les domaines sensibles, et des équipes de chercheurs capables de tenir tout ça en production.
Les modèles à poids ouverts changent la donne côté utilisateur : entraîner reste hors de portée, mais utiliser un très bon modèle chez soi est devenu accessible.
En résumé
Les LLM, ce sont des machines à prédire du texte. Rien de magique dans le principe.
Ce qui a changé depuis 2023, c’est l’échelle, le raisonnement, le multimodal et la capacité à agir. Assez pour transformer une bonne partie du travail de bureau, à condition de garder en tête ce que ces modèles ne savent pas faire : dire « je ne sais pas ».
Pour aller plus loin : notre guide de l’intelligence artificielle et le lexique pour ne plus jamais bloquer sur un sigle.