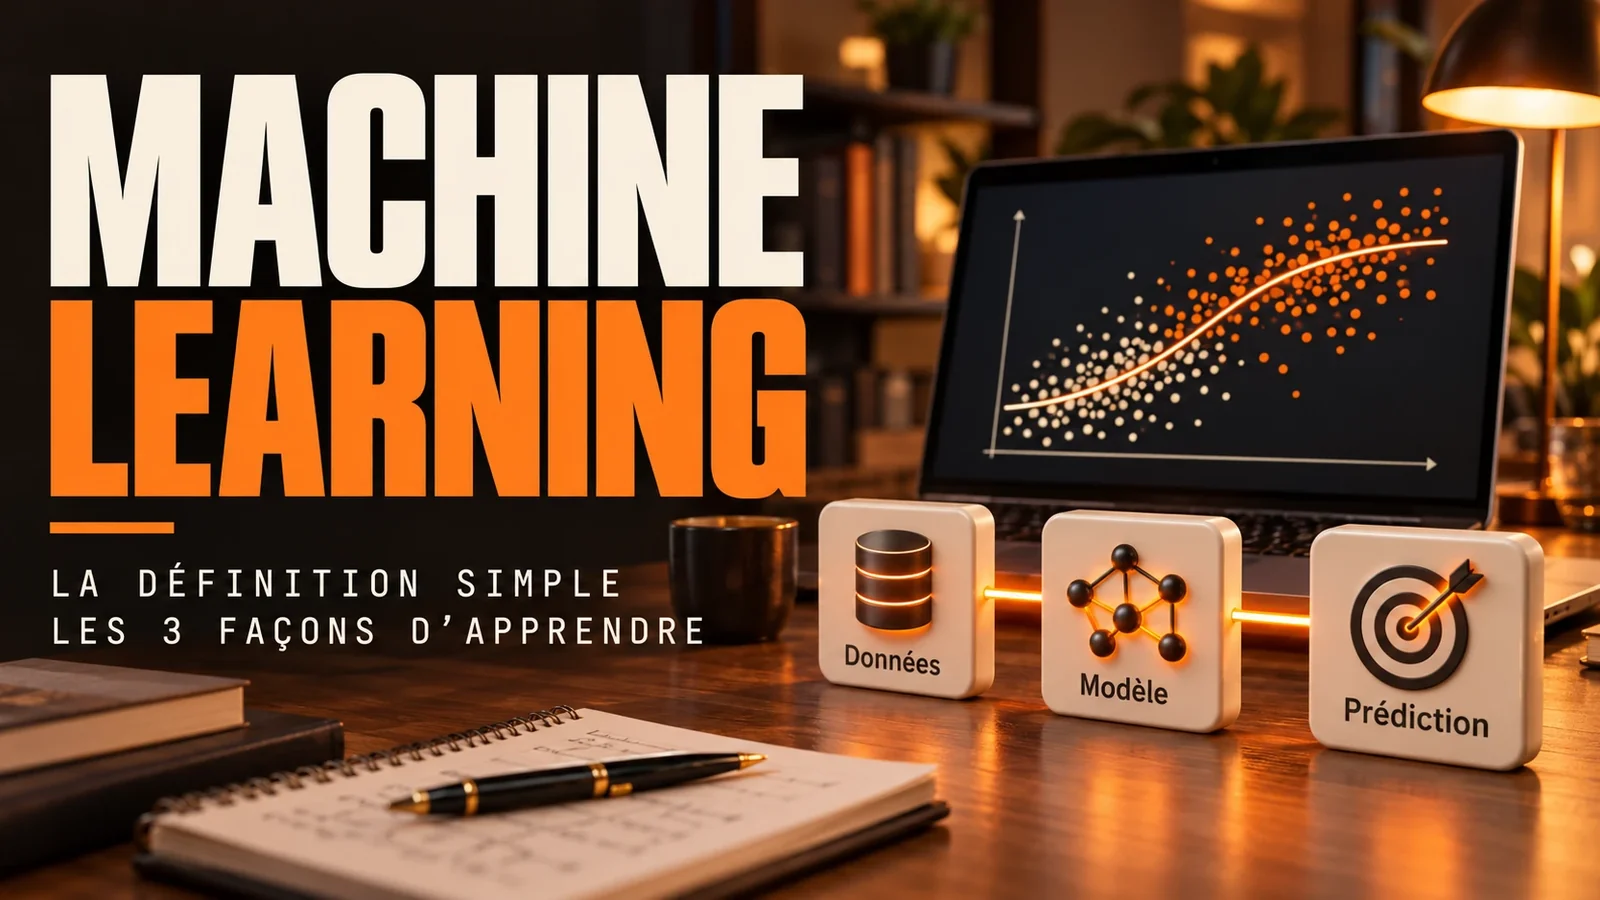


Le machine learning, ou apprentissage automatique en français, est une branche de l’intelligence artificielle dans laquelle un programme apprend une tâche à partir d’exemples, au lieu de suivre des règles écrites à la main par un développeur. Plus il voit de données de qualité, plus ses prédictions s’affinent : c’est la technique qui trie ton spam, choisit tes recommandations de séries et fait tourner ChatGPT.
Tu t’en sers tous les jours sans le voir. Quand ta banque bloque un paiement qui ne te ressemble pas, il y a derrière un modèle entraîné sur des exemples, pas une liste de règles.
Le mot, lui, a 67 ans, et l’idée n’a pas bougé : plutôt que d’expliquer à la machine comment faire, on lui montre le résultat attendu et on la laisse trouver le chemin. Cette page détaille l’entrée machine learning de notre lexique de l’IA. Pour la vue d’ensemble du domaine, lis notre guide de l’intelligence artificielle.
Le machine learning, c’est quoi concrètement ?
Imagine que tu veuilles apprendre à un programme à repérer les e-mails d’hameçonnage. Méthode classique : tu écris des règles (« objet contenant urgent + lien raccourci = suspect »). Les fraudeurs changent un mot, ta règle tombe. Sans fin.
Méthode machine learning : tu lui donnes des milliers d’e-mails déjà classés « frauduleux » ou « normal », et il trouve lui-même les indices qui séparent les deux piles, y compris ceux auxquels tu n’aurais pas pensé. La programmation classique donne une recette au cuisinier. Le machine learning lui fait goûter mille plats réussis et le laisse deviner la recette.
En français, le terme officiel est apprentissage automatique (ou apprentissage machine), recommandé depuis 2018 par la Commission d’enrichissement de la langue française, rappelle l’Office québécois de la langue française. La CNIL le définit comme le champ de l’IA qui donne aux machines la capacité d’apprendre à partir de données, via des modèles mathématiques.
L’expression vient d’Arthur Samuel, ingénieur chez IBM. En juillet 1959, il publie un article sur un programme de jeu de dames qui apprend à jouer mieux que la personne qui l’a programmé, en 8 à 10 heures de jeu machine.
Comment ça marche : données, modèle, entraînement, inférence
Prends un exemple simple : estimer le prix d’un appartement. Le machine learning passe par quatre étapes.
- Les données d’entraînement : des milliers de ventes passées, chacune avec ses caractéristiques (surface, quartier, étage, balcon) et la bonne réponse, le prix de vente réel.
- Le modèle : une formule mathématique pleine de réglages internes, les paramètres, réglés au hasard au départ.
- L’entraînement : le modèle devine un prix, on le compare au vrai, on corrige un peu les paramètres pour réduire l’écart. Et on recommence, des milliers de fois.
- L’inférence : le modèle entraîné reçoit un appartement qu’il n’a jamais vu et propose un prix.
Le piège classique s’appelle le surapprentissage : un modèle qui récite ses exemples par cœur, comme l’élève qui connaît les corrigés des annales et sèche dès que l’énoncé change. On garde donc toujours une partie des données de côté pour tester le modèle honnêtement.
Quand tu utilises un assistant comme ChatGPT, tu ne fais que de l’inférence. L’entraînement a eu lieu avant, chez l’éditeur, sur ses propres données d’entraînement.
Supervisé, non supervisé, par renforcement : les trois familles
Trois grandes façons d’apprendre coexistent, selon ce qu’on donne à la machine.
L’apprentissage supervisé : apprendre avec le corrigé
Chaque exemple arrive avec sa bonne réponse, son « étiquette » : spam ou pas spam. Le modèle apprend à prédire l’étiquette des cas suivants. Le filtre anti-spam est le cas d’école : en février 2019, Google indiquait que ses modèles aident à bloquer plus de 99,9 % du spam, de l’hameçonnage et des logiciels malveillants dans Gmail, et que TensorFlow, sa bibliothèque de machine learning, en arrêtait environ 100 millions supplémentaires chaque jour.
L’apprentissage non supervisé : trouver des groupes tout seul
Ici, pas de corrigé : le modèle cherche seul des ressemblances, comme si tu triais un carton de photos sans légende. C’est le principe de Google Photos, qui regroupe les visages appartenant probablement à la même personne avant même que tu leur donnes un nom. En entreprise, c’est la segmentation des clients.
L’apprentissage par renforcement : apprendre par essais et erreurs
Le modèle agit, reçoit une récompense ou une pénalité, et ajuste sa stratégie, comme un chien qu’on dresse avec des friandises. Le coup d’éclat date de mars 2016 : AlphaGo, de DeepMind, bat le champion de go Lee Sedol 4 à 1 à Séoul, après des milliers de parties contre ses propres versions.
Dans la vraie vie, les systèmes mélangent les familles. Le billet de lancement de ChatGPT, le 30 novembre 2022, décrit un ajustement supervisé sur des conversations écrites par des humains, puis un apprentissage par renforcement à partir de réponses classées par des évaluateurs : c’est le RLHF.
Machine learning vs deep learning (et IA, LLM) : qui contient quoi
Pense à des poupées russes : l’IA contient le machine learning, qui contient le deep learning, qui contient les LLM, les grands modèles de langage.
Toute l’IA n’est donc pas du machine learning. L’AI Act européen le dit dans son considérant 12 : un système d’IA peut apprendre à partir des données, ou s’appuyer sur la logique et sur des connaissances encodées par des humains.
| Ce que c’est | Comment ça apprend | Exemple | |
|---|---|---|---|
| IA | Le domaine entier, né à Dartmouth en 1956 | Par des règles écrites ou par apprentissage | Un système expert fait de règles « si… alors… » |
| Machine learning | Une branche de l’IA, nommée en 1959 | Par l’exemple, sur des caractéristiques souvent choisies par un humain | Filtre anti-spam, score de fraude |
| Deep learning | Une branche du machine learning, qui décolle en 2012 | Avec des réseaux de neurones à nombreuses couches, sur des données brutes | Reconnaissance d’images, traduction automatique |
| LLM | Des modèles de deep learning spécialisés dans le langage, grand public depuis fin 2022 | En prédisant la suite d’un texte sur d’immenses corpus, puis ajustés par des humains | ChatGPT, Claude, Mistral |
La vraie différence entre machine learning « classique » et deep learning tient à une question : qui choisit les indices ? En classique, un humain décide quoi regarder (la surface, le quartier). En deep learning, le réseau trouve seul ses indices dans les pixels, les sons ou les mots, au prix de bien plus de données et de calcul, et de décisions plus dures à expliquer. Pour des ventes ou des stocks rangés en tableau, un modèle classique reste souvent le choix raisonnable.
Le deep learning en deux minutes
Le deep learning, ou apprentissage profond, empile des couches de neurones artificiels. Chaque couche transforme ce qu’elle reçoit et passe le résultat à la suivante : sur une photo, les premières repèrent des contours, les suivantes des formes, les dernières des objets.
L’idée est ancienne, mais elle a explosé en 2012. Au concours ImageNet, le réseau d’Alex Krizhevsky, Ilya Sutskever et Geoffrey Hinton, à Toronto, se trompe sur 15,3 % des images, contre 26,2 % pour l’équipe suivante (en ayant droit à cinq propositions par image). Il comptait 60 millions de paramètres. GPT-3, en 2020, en avait 175 milliards : près de 3 000 fois plus.
Le Français Yann LeCun a reçu le prix Turing 2018 avec Hinton et Yoshua Bengio pour ces travaux. Le Nobel de physique 2024 est allé à Hinton et John Hopfield, pour des découvertes et inventions fondatrices qui rendent possible l’apprentissage automatique avec des réseaux de neurones artificiels.
Où tu croises le machine learning tous les jours
- Tes recommandations. Netflix explique que ses algorithmes croisent ton historique, tes évaluations et les choix d’abonnés aux goûts proches pour prédire ce qui te plaira.
- Ta carte bancaire. D’après Visa, son système antifraude analyse jusqu’à 400 caractéristiques de chaque paiement en moins d’une milliseconde pour lui attribuer un score de risque.
- La traduction. DeepL, une entreprise de Cologne, a lancé fin août 2017 un traducteur fondé sur des réseaux de neurones : du deep learning, donc du machine learning.
- Ton assistant IA. ChatGPT, Claude ou Mistral sont des LLM : la partie visible d’une technique qui tournait en coulisses depuis des années.
Les limites du machine learning
Un modèle apprend des régularités, pas des vérités. Quatre limites à garder en tête.
Il reproduit les biais de ses données. En octobre 2018, Reuters révèle qu’Amazon a abandonné un outil de tri de CV. Entraîné sur dix ans de candidatures surtout masculines, il pénalisait les CV contenant le mot « women’s » (Amazon affirme que ses recruteurs ne s’en sont jamais servis pour évaluer des candidats). Le modèle a simplement appris le passé tel qu’il était : c’est le biais algorithmique.
Il ne vaut que ce que valent ses données, et le monde change. Zillow, géant américain de l’immobilier, achetait des maisons sur la foi de ses prévisions de prix. En novembre 2021, il ferme l’activité après 304 millions de dollars de dépréciation : l’imprévisibilité des prix dépassait de loin ce qu’il anticipait, reconnaît son PDG. Un modèle entraîné sur le passé décroche quand le marché sort de ses habitudes.
Il explique mal ses décisions. C’est l’effet « boîte noire », surtout en deep learning : le résultat tombe sans explication. En Europe, l’article 22 du RGPD te donne le droit de ne pas faire l’objet d’une décision fondée exclusivement sur un traitement automatisé qui t’affecte de manière significative. Quand une exception s’applique, tu peux au minimum obtenir une intervention humaine et contester.
Il consomme de l’électricité. D’après l’Agence internationale de l’énergie (avril 2026), les centres de données ont consommé 485 TWh en 2025, un peu plus que toute la France métropolitaine sur la même année (451 TWh selon RTE). L’agence prévoit environ 950 TWh en 2030. Nuance : ce chiffre couvre tous les centres de données, pas seulement l’IA, et l’énergie consommée par tâche d’IA baisse très vite.
Ce que le machine learning change pour toi
Pas besoin de devenir data scientist. Trois réflexes suffisent.
Quand une décision te concerne, demande qui l’a prise. Crédit refusé, candidature écartée, contrat d’assurance rejeté : si un algorithme a tranché seul, l’article 22 du RGPD est ton levier pour exiger un regard humain.
Essaie sans coder. Teachable Machine, un outil gratuit de Google, entraîne un modèle à reconnaître tes images, sons ou postures sans une ligne de code. Montre-lui une trentaine de photos d’une tasse et autant d’un stylo, puis change la lumière : tu verras vite pourquoi la qualité des exemples compte.
Forme-toi sur les bases, pas sur les outils. À mon avis, la meilleure porte d’entrée gratuite reste Elements of AI, de l’Université d’Helsinki et MinnaLearn : en français, sans programmation ni mathématiques avancées. Le MOOC Class’Code IAI d’Inria demande environ 10 heures à ton rythme. Pour un parcours encadré, notre page formation IA fait le tri entre les offres, du gratuit au financé par le CPF.
Pour l’appliquer à ton métier, deux prompts à copier :
Je travaille comme [ton métier]. Explique-moi le machine learning avec trois exemples tirés de mon secteur : un supervisé, un non supervisé, un par renforcement. Pour chacun, dis-moi quelles données il faudrait et ce qui pourrait mal tourner.
Je veux [ta tâche, par exemple prévoir mes ventes du mois prochain]. Avant de répondre, pose-moi trois questions sur mes données. Ensuite, dis-moi si un modèle de machine learning classique suffit ou s’il faut une IA générative, et pourquoi.
Pour aller plus loin, les mots qui gravitent autour : modèle, fine-tuning, LLM et agent IA.
Questions fréquentes
Comment dit-on machine learning en français ?
Le terme officiel est « apprentissage automatique », avec « apprentissage machine » comme synonyme : les deux sont recommandés depuis 2018 par la Commission d’enrichissement de la langue française. Dans les faits, l’anglais « machine learning » reste bien plus utilisé.
Quelle est la différence entre l’IA et le machine learning ?
L’IA est le domaine entier ; le machine learning est une façon d’en faire, par l’exemple. Une IA peut aussi fonctionner avec des règles écrites par des humains, ce que l’AI Act européen distingue explicitement. Aujourd’hui, presque toutes les IA dont on parle reposent sur du machine learning.
Quelle est la différence entre machine learning et deep learning ?
Le deep learning est une branche du machine learning qui empile des couches de neurones artificiels. Il trouve seul ses indices dans des données brutes (images, sons, textes), là où le machine learning classique travaille sur des caractéristiques choisies par un humain. En contrepartie, il demande plus de données et de calcul.
Quels sont les 3 types de machine learning ?
L’apprentissage supervisé apprend à partir d’exemples étiquetés, comme un filtre anti-spam. L’apprentissage non supervisé cherche des groupes dans des données sans étiquette, comme le regroupement de visages dans une appli photo. L’apprentissage par renforcement apprend par essais et erreurs, comme AlphaGo en 2016.
ChatGPT, c’est du machine learning ?
Oui. ChatGPT repose sur un LLM, un modèle de deep learning, donc du machine learning. À son lancement, le 30 novembre 2022, OpenAI décrivait un ajustement supervisé suivi d’un apprentissage par renforcement à partir de retours humains.
Faut-il savoir coder pour faire du machine learning ?
Pour comprendre et expérimenter, non : Teachable Machine de Google entraîne un modèle sans code, et Elements of AI explique les bases sans programmation. Pour construire tes propres modèles, oui : il faut apprendre à programmer, en général en Python, et des bases de statistiques.